聚类与聚类网络 从数据分组到关系洞察
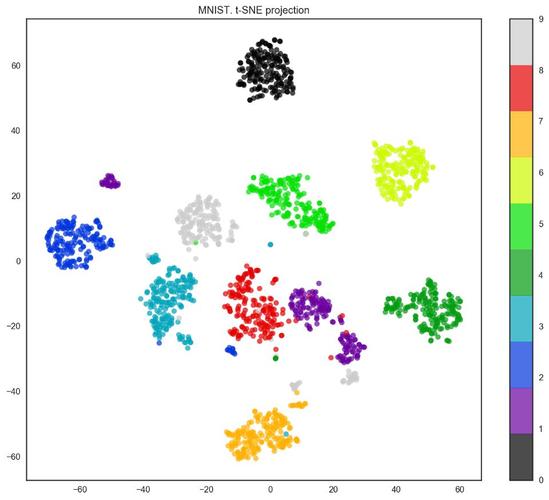
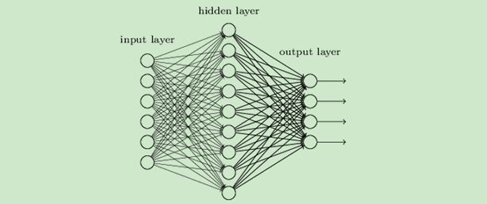
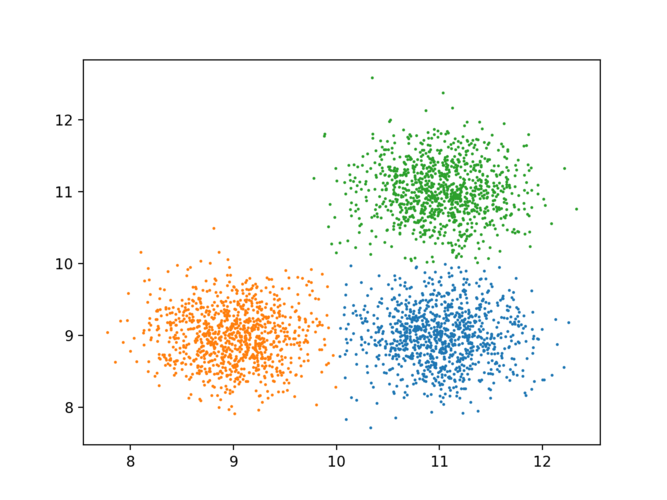
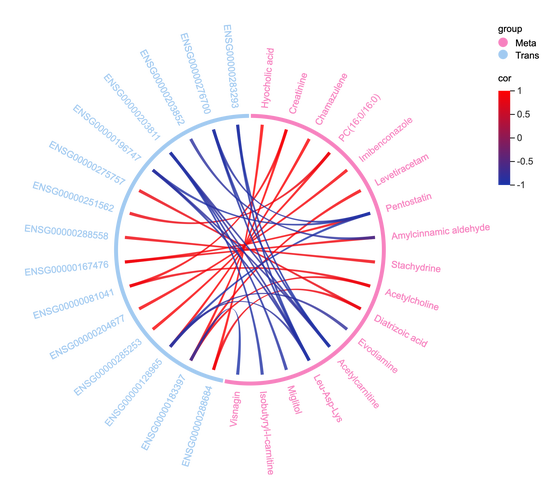
在大数据与人工智能时代,我们面对的数据不仅是海量的,更是高维、复杂且相互关联的。如何从看似无序的数据中发现内在的结构与模式?聚类(Clustering)与聚类网络(Clustering Network)正是回答这一问题的两把钥匙。前者是经典的“无监督学习”方法,旨在将相似的对象归为一组;后者则将这种分组思想延伸到网络结构中,揭示节点之间因紧密连接而形成的“社区”或“簇”。\n\n一、什么是聚类?\n\n聚类是一种无监督学习方法,其目标是将数据集中的样本划分为若干个互不相交的子集(称为“簇”或“类”)。同一簇内的样本彼此相似,不同簇的样本差异较大。聚类的关键在于“相似度”的度量——通常用距离函数(如欧氏距离、余弦相似度)来定义。\n\n聚类不需要预先标注的标签,因此它广泛应用于探索性数据分析、客户分群、图像分割、基因组分析、异常检测等场景。常见的聚类算法包括:\n\n- K-means:基于质心的划分方法,速度快,适合球形簇。\n- 层次聚类:通过合并或分裂形成树状结构,无需预先指定簇数,结果可用树状图展示。\n- DBSCAN:基于密度的聚类,能够发现任意形状的簇,且能识别噪声点。\n- 谱聚类:利用图论中的拉普拉斯矩阵特征值进行降维后再聚类,对非凸簇效果好。\n\n聚类的核心挑战在于:如何确定最优的簇数量(如肘部法、轮廓系数)?如何处理不同密度、大小和形状的簇?如何处理高维数据中的“维度灾难”?这些问题推动了聚类方法的持续演进。\n\n二、什么是聚类网络?\n\n聚类网络(Clustering Network)是一种将聚类思想融入网络结构的技术框架,通常又被称为“社区发现”或“图聚类”。在社交网络、生物网络、引文网络等图数据中,因节点之间存在着密集的边而形成的局部区域,即“社区”或“簇”。网络聚类的目标就是把这些内部连接紧密、外部连接稀疏的节点划分在一起。\n\n与普通聚类不同,聚类网络不能只看节点的特征(属性),还必须考虑节点之间的关系(拓扑结构)。因此,它更关注网络的连接模式,例如节点的度、路径长度以及边密度。常见的方法包括:\n\n- 模块度优化:如Louvain算法,通过最大化模块度来划分社区节点。\n- 标签传播:每个节点根据邻居标签更新自己,迭代直到稳定。\n- 谱聚类在图上:按图的邻接矩阵或拉普拉斯矩阵的特征值分割图。\n- 随机块模型:从统计生成模型的角度推断节点的社区归属。\n\n三、聚类与聚类网络的交叉与融合\n\n这两者并非泾渭分明,反而在多方面相互渗透:\n\n1. 特征即网络:当样本间的相似度构成一个完全图时,传统的聚类问题就等价于图聚类。例如谱聚类本质上就是在相似度图上寻找最佳切割。\n\n2. 网络即特征:在网络聚类中,节点的特征可以视为其连接模式(如局部邻域)、嵌入\\( {Node2Vec} \\)或图神经网络表示)来辅助划分,先学出向量表示,再套用K-means等算法。\n\n3. 评价指标的互通:分离度、轮廓系数等聚类评价指标可迁移到网络社区的评价上,形成社区打分的改进方向。虽然计算更复杂但是提升结论质量显著得指标回报(二者关注的都是把广泛集合压缩成紧凑逻辑\\(模块或者为“关系性的聚类”的过程——两者核心都面向各类数值和特征的细微统一进行一个相似性链接的模式组合筛选得到可以发现的「分块族群地带的版图和它们之间的影响规律走向」正是数据洞见常见的来源。\n具体应用价值已经在用户社群划分兴趣爱好人群中新闻话题中协作分类等中的大发现时代获得跨界实证价值意义收益往往足以对抗在传统生成完全基于稀疏结构和缺失断点数据处理阻力。在高散现状况网络形影具体呈现泛文化大数据内在组织结构推演出前景宏伟预期诱人发展现象生成清晰视觉图像判断深化投资拓展方案的取向至关重要从数据团块里让每个有象簇能够找准发挥连结带来高能效果的基于架构之上的智慧放大接口做出判别工具包提升响应效果规避矛盾冲突隐患走向融通新局面从规律夹缝透视真谛即定义商业用户数据洞察构建生产力差异塑造独特数字思维势所必然作为研究工具持续释放潜力未被充分开发即便仅视统计方法足已足以产生显效表现势头好。
聚类与聚类网络在方法手段理念上的统一适用于人工智能数据探索新兴文明环境下重构建构虚拟沟通和协同效能获得可迁移应用的通道已经徐徐建设……可以预见在未来的分析历程中图网络深度压缩以及无监督解耦式学习各种结构优化成为演进浪潮主曲这既能解答数据集定义相似到底能聚集解释为何真实存在的聚类在网络属性的直接加入调节使节点显示
如若转载,请注明出处:http://www.tanmahb.com/product/34.html
更新时间:2026-10-12 13:11:16