基于词云、文本聚类与LDA主题模型的新闻文本挖掘 从抓取到聚类网络可视化
一、引言
在信息爆炸的时代,新闻媒体每天产出海量文本数据。如何从这些非结构化文本中快速提取关键信息、发现潜在主题、识别新闻事件的分布与关联,成为文本挖掘领域的重要课题。本文围绕“新闻信息抓取→词云可视化→文本聚类→LDA主题模型→聚类网络”这一完整技术链路,介绍各环节的核心方法、实现工具与实战要点,帮助读者构建端到端的新闻文本分析系统。
二、新闻信息抓取
2.1 数据源选择
新闻抓取的第一步是确定目标站点。常见来源包括:
- 综合门户:新浪新闻、腾讯新闻、网易新闻
- 垂直媒体:36氪、虎嗅、财新网
- 聚合平台:今日头条、百度新闻
- 英文源:BBC、CNN、Reuters
建议优先选择结构清晰、反爬策略较宽松的站点,并遵守robots.txt协议与相关法律法规。
2.2 抓取工具
- Requests + BeautifulSoup:适合静态页面,轻量灵活
- Scrapy:适合大规模、多页面爬取,支持中间件与管道
- Selenium / Playwright:适合JavaScript渲染的动态页面
- NewsPlease / newspaper3k:专为新闻正文提取设计的库,可自动识别标题、作者、正文、发布时间
2.3 抓取流程
- 构造URL列表(栏目页、分页参数)
- 发送HTTP请求,处理Cookies、Headers、代理
- 解析HTML,提取标题、正文、时间、来源、链接
- 正文清洗:去除广告、导航、评论区、HTML标签
- 存储为CSV/JSON/数据库(MySQL、MongoDB)
2.4 注意事项
- 控制请求频率,避免对目标站点造成压力
- 使用随机User-Agent、IP代理池
- 增量抓取:记录已抓取URL,支持断点续爬
三、中文分词与预处理
新闻文本挖掘的基础是分词与清洗。
- 分词工具:jieba、HanLP、THULAC、pkuseg
- 去停用词:哈工大停用词表、百度停用词表、四川大学机器智能实验室停用词库
- 自定义词典:加入新闻领域专有名词(如“元宇宙”“碳中和”“专精特新”)
- 标准化:统一全半角、去除特殊符号、数字归一化
示例(Python):`python
import jieba
import re
def clean_text(text):
text = re.sub(r'[^\u4e00-\u9fa5a-zA-Z0-9]', ' ', text)
words = jieba.lcut(text)
stopwords = set(open('stopwords.txt', encoding='utf-8').read().split())
return [w for w in words if w not in stopwords and len(w) > 1]`
四、词云可视化
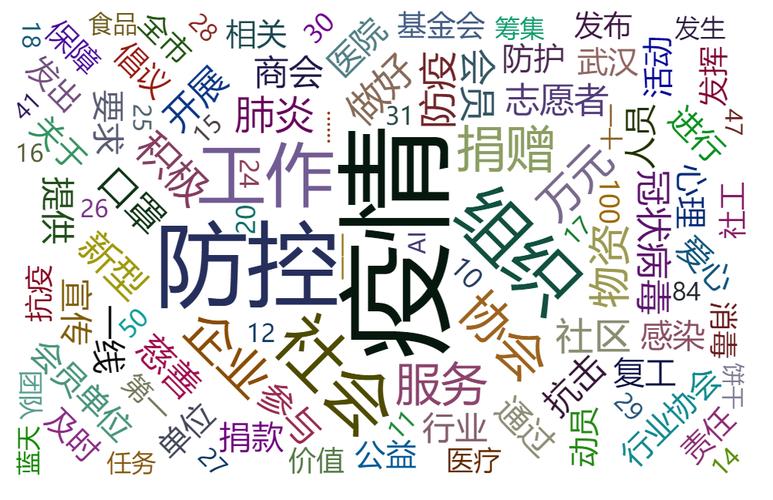
词云是文本挖掘最直观的呈现方式,通过词频与权重展现新闻热点。
4.1 实现工具
- WordCloud(Python):最常用,支持自定义背景、字体、蒙版
- pyecharts:生成交互式词云
- ECharts / D3.js:前端词云
4.2 关键步骤
- 统计词频(Counter)
- 可选:TF-IDF加权,突出区分性词汇
- 设置中文字体(如simhei.ttf),避免乱码
- 使用蒙版图(mask)定制形状
- 调整maxwords、backgroundcolor、colormap
4.3 解读要点
- 词云反映高频词汇,但不直接等于主题
- 需结合停用词与领域词典,避免“记者”“报道”等噪声词
- 可与时间维度结合,生成动态词云
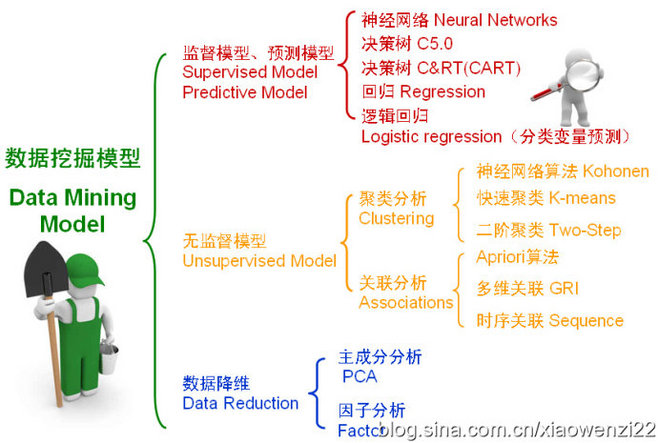
五、文本聚类
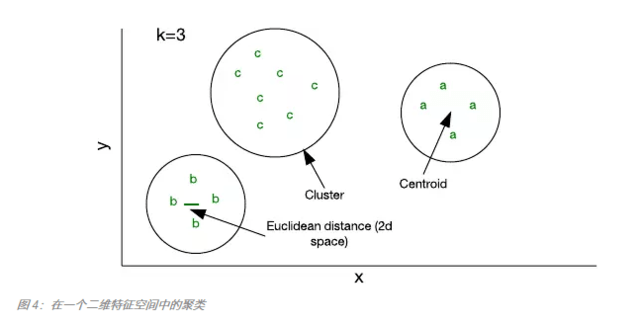
文本聚类将相似新闻自动分组,发现事件簇或话题类。
5.1 文本表示
- TF-IDF:经典稀疏表示,适合KMeans
- Word2Vec / GloVe:词向量平均或加权
- Doc2Vec:直接学习文档向量
- BERT / Sentence-BERT:上下文嵌入,语义捕捉强
5.2 聚类算法
- KMeans:需预设K,适合球形簇
- DBSCAN:自动发现簇数,可识别噪声
- 层次聚类:生成树状图,便于探索
- HDBSCAN:改进密度聚类,适应变密度
- LDA + 聚类:先用LDA降维,再聚类
5.3 评估指标
- 轮廓系数(Silhouette Score)
- Calinski-Harabasz Index
- Davies-Bouldin Index
- 人工抽查簇内一致性
5.4 示例流程
`python
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.cluster import KMeans
vectorizer = TfidfVectorizer(maxfeatures=5000)
X = vectorizer.fittransform(corpus)
kmeans = KMeans(nclusters=10, randomstate=42)
labels = kmeans.fit_predict(X)`
六、LDA主题模型
LDA(Latent Dirichlet Allocation)是一种生成式概率模型,将文档视为多个主题的混合,每个主题是词的概率分布。
6.1 原理简述
- 每篇文档有一个主题分布 θ ~ Dirichlet(α)
- 每个主题有一个词分布 φ ~ Dirichlet(β)
- 对文档中每个词:先采样主题 z ~ θ,再采样词 w ~ φ_z
- 通过Gibbs采样或变分推断求解
6.2 实现工具
- Gensim:ldamodel、LdaMulticore
- scikit-learn:LatentDirichletAllocation
- Mallet:Java实现,主题质量常更优
6.3 关键参数
- num_topics:主题数,可用困惑度(Perplexity)或一致性(Coherence)选择
- alpha、beta:先验参数,常用1/主题数、1/词数
- passes、iterations:训练轮次
6.4 结果解读
- 每个主题输出Top-N词,人工命名
- 文档-主题分布可用于分类、推荐
- 主题随时间演化可做动态主题模型(DTM)
`python
from gensim import corpora, models
dictionary = corpora.Dictionary(tokenizeddocs)
corpus = [dictionary.doc2bow(doc) for doc in tokenizeddocs]
lda = models.LdaModel(corpus, numtopics=10, id2word=dictionary, passes=15)
for topic in lda.printtopics(num_words=8):
print(topic)`
七、聚类网络与主题关联可视化
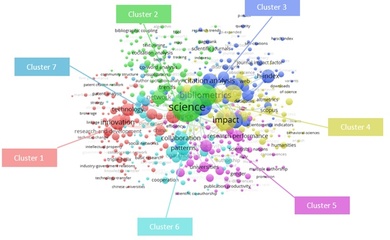
聚类网络将新闻、主题、词之间的关联以图结构呈现,揭示全局模式。
7.1 网络构建方式
- 文档-文档网络:边权重为相似度(余弦、JS散度),阈值过滤后聚类
- 主题-词网络:节点为主题与词,边为主题中词的概率
- 文档-主题-词三层网络:更全面但复杂
- 共现网络:词与词在窗口内共现,揭示语义关联
7.2 可视化工具
- NetworkX + Matplotlib:基础图论分析
- Gephi:交互式探索,适合大型网络
- PyVis:生成HTML交互图
- ECharts Graph:前端动态图
- igraph:高效社区发现
7.3 社区发现
- Louvain、Leiden算法:自动划分新闻簇
- 模块度(Modularity)评估划分质量
- 结合LDA主题标签,为每个社区命名
7.4 示例:新闻相似度网络
- 计算两两文档余弦相似度
- 保留阈值以上的边
- 用ForceAtlas2布局
- 节点大小=词数/影响力,颜色=聚类标签
- 叠加LDA主题词作为注解
八、完整实战流程
- 抓取:Scrapy/Requests抓取新闻标题、正文、时间
- 预处理:jieba分词、去停用词、自定义词典
- 词云:WordCloud生成热点图
- 表示:TF-IDF或Sentence-BERT向量化
- 聚类:KMeans/DBSCAN分组,评估轮廓系数
- LDA:Gensim训练主题模型,选择最优主题数
- 网络:构建文档相似度网络或主题-词网络
- 可视化:PyVis/Gephi展示聚类结构与主题关联
- 解读:结合业务背景命名簇与主题,输出分析报告
九、挑战与展望
- 短文本稀疏:新闻标题短,需结合正文或外部知识
- 动态演化:新闻事件快速变化,需在线学习与增量聚类
- 多模态:图文、视频新闻需跨模态挖掘
- 大模型时代:LLM可用于主题生成、聚类标签自动命名、零样本分类,与传统方法互补
- 可解释性:聚类与主题模型需提供可理解的解释,辅助决策
十、
从新闻抓取到词云、文本聚类、LDA主题模型,再到聚类网络可视化,形成了一套完整的文本挖掘流水线。该链路不仅能帮助媒体从业者洞察热点,也可服务于舆情监控、市场分析、学术研究。随着大模型与图神经网络的发展,新闻文本挖掘将更加智能化、动态化与可解释化。掌握这些方法,便能在信息洪流中抽丝剥茧,发现数据背后的故事。
如若转载,请注明出处:http://www.tanmahb.com/product/59.html
更新时间:2026-10-22 06:20:24