基于系统聚类分析的网络入侵检测研究
随着互联网技术的迅猛发展,网络攻击手段日益复杂多样,传统的基于特征匹配的入侵检测方法已难以应对未知攻击和变种攻击。网络入侵检测作为网络安全防御体系中的重要环节,正面临新的挑战。在此背景下,无监督学习方法受到越来越多研究者的关注。其中,聚类分析因其无需先验标签即可发现数据内在结构的能力,被广泛应用于网络入侵检测领域。本文围绕基于系统聚类分析的网络入侵检测方法展开探讨,分析其原理、实现流程及其在实际应用中的优势与局限。
一、网络入侵检测概述
网络入侵检测系统(Intrusion Detection System, IDS)通过采集网络流量或主机日志数据,识别异常行为或已知攻击模式。按照检测方式可分为误用检测和异常检测两大类。误用检测依赖已知攻击特征库,对未知攻击的检测能力有限;异常检测则通过建立正常行为模型,将偏离模型的行为判定为异常。聚类分析属于典型的异常检测方法之一,能够在无标签条件下对数据样本进行分组,从而实现入侵行为的发现。
二、系统聚类分析的基本原理
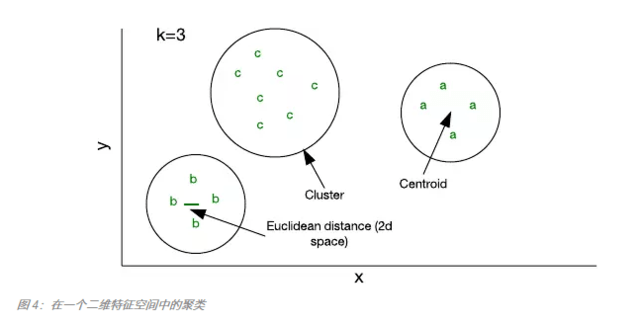
系统聚类(Hierarchical Clustering)是一种经典的聚类方法,其核心思想是通过逐步合并或分裂样本,构建具有层次结构的聚类树(树状图)。根据合并策略的不同,系统聚类可分为单链、全链、平均链以及Ward方法等。其中,Ward方法以最小化簇内方差为目标,在实际应用较为广泛。系统聚类不依赖预先指定的簇数量,能够通过树状图和距离阈值来确定聚类结果,适合探索性数据分析。
在网络入侵检测中,通常将网络连接记录表示为特征向量,例如连接持续时间、协议类型、传输字节数、登录失败次数等。不同攻击类型(如拒绝服务攻击、端口扫描、远程未授权访问等)在特征空间中往往呈现不同的分布模式。系统聚类能够将这些样本按相似性进行分组,使同簇样本具有较高相似度,而不同簇之间差异较大,进而辅助识别异常簇。
三、基于系统聚类的入侵检测流程
基于系统聚类分析的网络入侵检测一般包括以下步骤:
数据预处理。对原始网络流量数据进行清洗、缺失值处理和归一化,消除量纲差异对距离计算的影响。
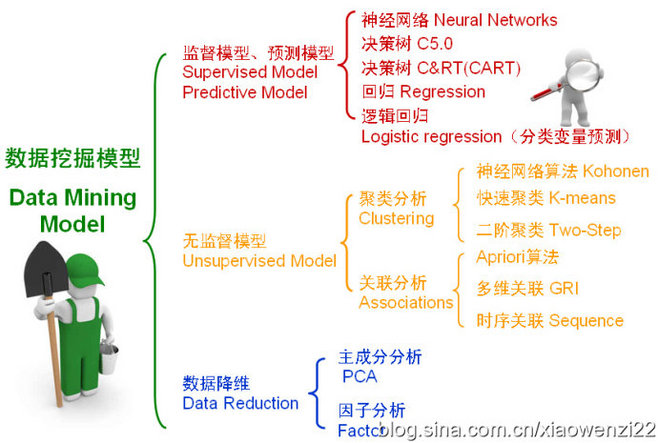
特征选择与降维。从大量特征中筛选与入侵行为相关性较高的特征,必要时采用主成分分析等方法降低维度,以提高聚类效率和准确性。
距离度量与聚类。选择合适距离度量(如欧氏距离、曼哈顿距离)和聚类策略,构建聚类树并对样本进行划分。
异常判定。根据簇的大小、密度以及簇内样本与正常行为模型的偏离程度,将远离主要数据分布的小簇标记为异常或攻击。
结果评估。利用有标签数据集(如KDD Cup 99、NSL-KDD等)对检测结果进行评估,采用检测率、误报率、F1值等指标衡量方法性能。
四、系统聚类在网络入侵检测中的优势与局限
系统聚类分析方法具有以下优势:第一,无需标签数据,适用于标注成本高昂的场景;第二,能够发现未知攻击,弥补传统误用检测的不足;第三,层次结构可视化有助于分析人员理解攻击行为的分布规律。
系统聚类也存在明显局限。一方面,其时间复杂度较高,处理大规模网络流量数据时计算开销大;另一方面,聚类结果对距离度量和预处理方式较为敏感,参数选择不当可能导致误报率升高。网络流量中存在大量噪声和类别不平衡问题,也会影响聚类效果。
五、改进方向与发展趋势
为提升系统聚类在网络入侵检测中的适用性,研究者提出了多种改进思路。一是将系统聚类与分割聚类(如K-means、DBSCAN)结合,先降采样再聚类,以降低计算复杂度;二是引入半监督学习,在少量标签引导下优化聚类边界;三是结合深度学习特征提取方法,自动学习更具判别性的流量表示;四是采用增量式聚类,支持在线流量数据的实时检测。
随着网络攻击不断演化,基于系统聚类分析的入侵检测方法仍然具有重要的研究价值。未来的研究可在提高检测精度、降低误报率以及增强实时性等方面持续深入,为构建更加智能和自适应的网络安全防御体系提供支撑。
如若转载,请注明出处:http://www.tanmahb.com/product/63.html
更新时间:2026-10-22 02:32:45